Domain gtlg.de kaufen?
Wir ziehen mit dem Projekt
gtlg.de um.
Sind Sie am Kauf der Domain
gtlg.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain gtlg.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Kermi Aufpreis Sonderkonstruktion - DienstleistungDie Fakten - Maßanpassungen vor Ort – z. B. Zuschneiden von Profilen oder Glaselementen wegen schiefer Wände oder Sondermaßen - Sonderbefestigungen – Montage bei schwierigen Wandmaterialien (Naturstein, Porenbeton, Trockenbau mit Verstärkung etc.) - Individuelle Abdichtungslösungen – zusätzliche Silikonfugen, Spezialdichtprofile, Anpassungen bei unebenen Flächen - Anpassung an bauliche Besonderheiten – Dachschrägen, Vorsprünge, Nischen, Rohre, Fensterbänke - Zusatzkonstruktionen – Haltewinkel, Verstärkungsleisten oder Sonderhalterungen, die nicht im Standard-Montagesatz enthalten sind - Erhöhter Montageaufwand – deutlich längere Arbeitszeit wegen komplizierter Einbausituation99,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
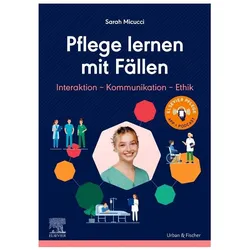
Pflege lernen mit Fällen, Interaktion - Kommunikation - Ethik, Fachbücher von Sarah MicucciLernen mit Fällen - so werden Sie fit für jede Pflegesituation! In der generalistischen Pflegeausbildung werden Sie in vielen verschiedenen Praxisfeldern eingesetzt und müssen das Gelernte ständig neu hinterfragen. Damit Ihnen das gelingt, üben Sie in diesem Buch, Ihr Wissen individuell anzuwenden und lernen, wie Beziehungsaufbau mit Patienten, Bewohnern, An- und Zugehörigen gelingen kann. Sie lernen den Umgang mit Trauer, Verlust, Überforderung, interkultureller Kommunikation und vielem mehr. Dieses Buch begleitet Sie über die drei Jahre Ausbildungszeit und hilft Ihnen ganz besonders beim Aufbau von Pflegebeziehungen. Das Buch eignet sich für Pflege-Auszubildende.25,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
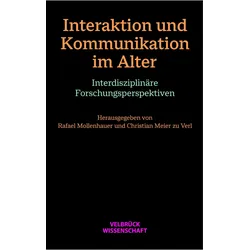
Interaktion und Kommunikation im Alter, Fachbücher von Rafael Mollenhauer, Christian Meier Zu VerlBefördert durch eine stetige Zunahme des Anteils älterer Menschen an der Gesamtbevölkerung erfährt das Thema Alter im deutschsprachigen Diskurs ein zunehmendes Interesse, das sich auch in einer stetig wachsenden Zahl sozial- und kulturwissenschaftlicher Auseinandersetzungen mit Phänomenen des Alterns widerspiegelt. Eine gerontologische Kommunikationsforschung zeichnet sich hingegen erst allmählich im interdisziplinären und internationalen Feld der Aging Studies ab. Dies nimmt der Band Kommunikation im Alter zum Anlass, aktuelle theoretische und empirische Arbeiten aus dem deutschsprachigen Raum zu versammeln, die die kommunikationstheoretischen Überlegungen der Aging Studies aufgreifen, neu kontextualisieren und weiterdenken. Die Beiträge des Bandes behandeln das Phänomen Altern aus soziologischer, kommunikationstheoretischer und -empirischer, linguistischer und auch gerontologischer Perspektive. Im ersten Teil rückt die Frage nach Möglichkeiten einer näheren Bestimmung von Kommunikation im Alter in den Fokus. In diesem Rahmen wird Alter nicht als statische, sondern als relationale Grösse entworfen, die im Alltag und in der Wissenschaft immer nur bis auf weiteres und kontextspezifisch bestimmbar ist. Im zweiten Teil wird die kontextuelle und kulturelle Variabilität von Alterskonzepten anhand empirisch fundierter Beiträge zu kultur-, milieu- und situationsspezifisch variierenden Auslegungen und Überwindungen von Altersgrenzen vertieft. Der dritte Teil widmet sich schliesslich interaktiven Dimensionen alterstypischer degenerativer Erkrankungen wie Demenz und fragt, wie intersubjektive Kommunikation unter diesen Bedingungen überhaupt möglich ist.39,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Kermi Aufpreis Sonderkonstruktion - DienstleistungDie Fakten - Maßanpassungen vor Ort – z. B. Zuschneiden von Profilen oder Glaselementen wegen schiefer Wände oder Sondermaßen - Sonderbefestigungen – Montage bei schwierigen Wandmaterialien (Naturstein, Porenbeton, Trockenbau mit Verstärkung etc.) - Individuelle Abdichtungslösungen – zusätzliche Silikonfugen, Spezialdichtprofile, Anpassungen bei unebenen Flächen - Anpassung an bauliche Besonderheiten – Dachschrägen, Vorsprünge, Nischen, Rohre, Fensterbänke - Zusatzkonstruktionen – Haltewinkel, Verstärkungsleisten oder Sonderhalterungen, die nicht im Standard-Montagesatz enthalten sind - Erhöhter Montageaufwand – deutlich längere Arbeitszeit wegen komplizierter Einbausituation99,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
Kermi Montageaufpreis für Sonderbohrungen - DienstleistungSpezialbohrungen Beim Einbau unserer Duschkabinen auf speziellen Fliesen wie Granit, Feinsteinzeug oder sonstigen harten Fliesenmaterialen ist ein erhöhter Zeitaufwand und Spezialwerkzeug notwendig.149,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.